1체스판 위의 소년
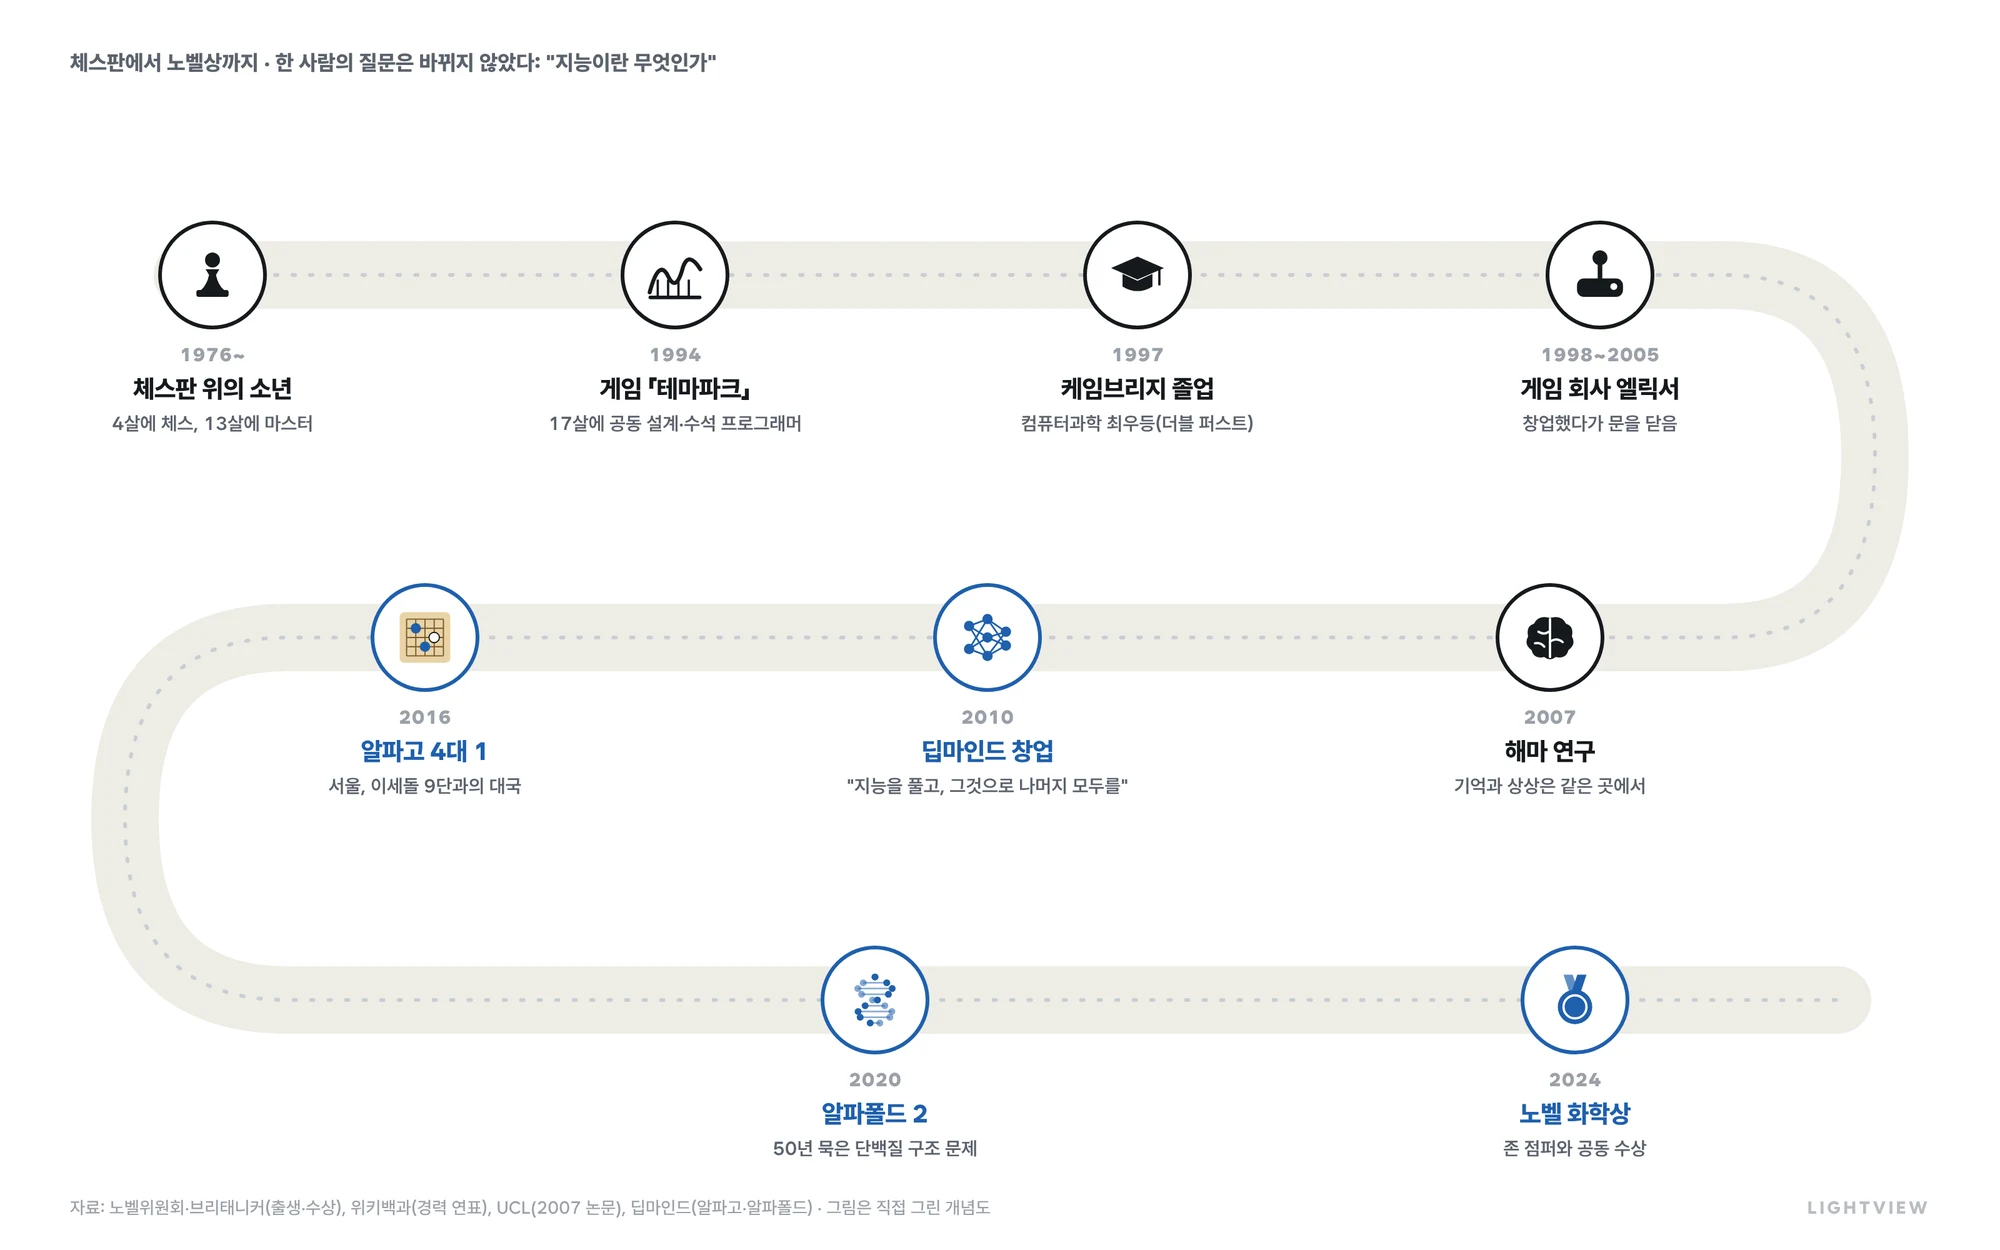
데미스 하사비스는 1976년 7월 런던에서 그리스계 키프로스인 아버지와 중국계 싱가포르인 어머니 사이에서 태어났습니다. 네 살에 어른들이 두는 체스를 보고 규칙을 익혔고, 열세 살에 마스터 수준(Elo 2,300)에 올라 또래 가운데 세계 2위로 꼽혔습니다.
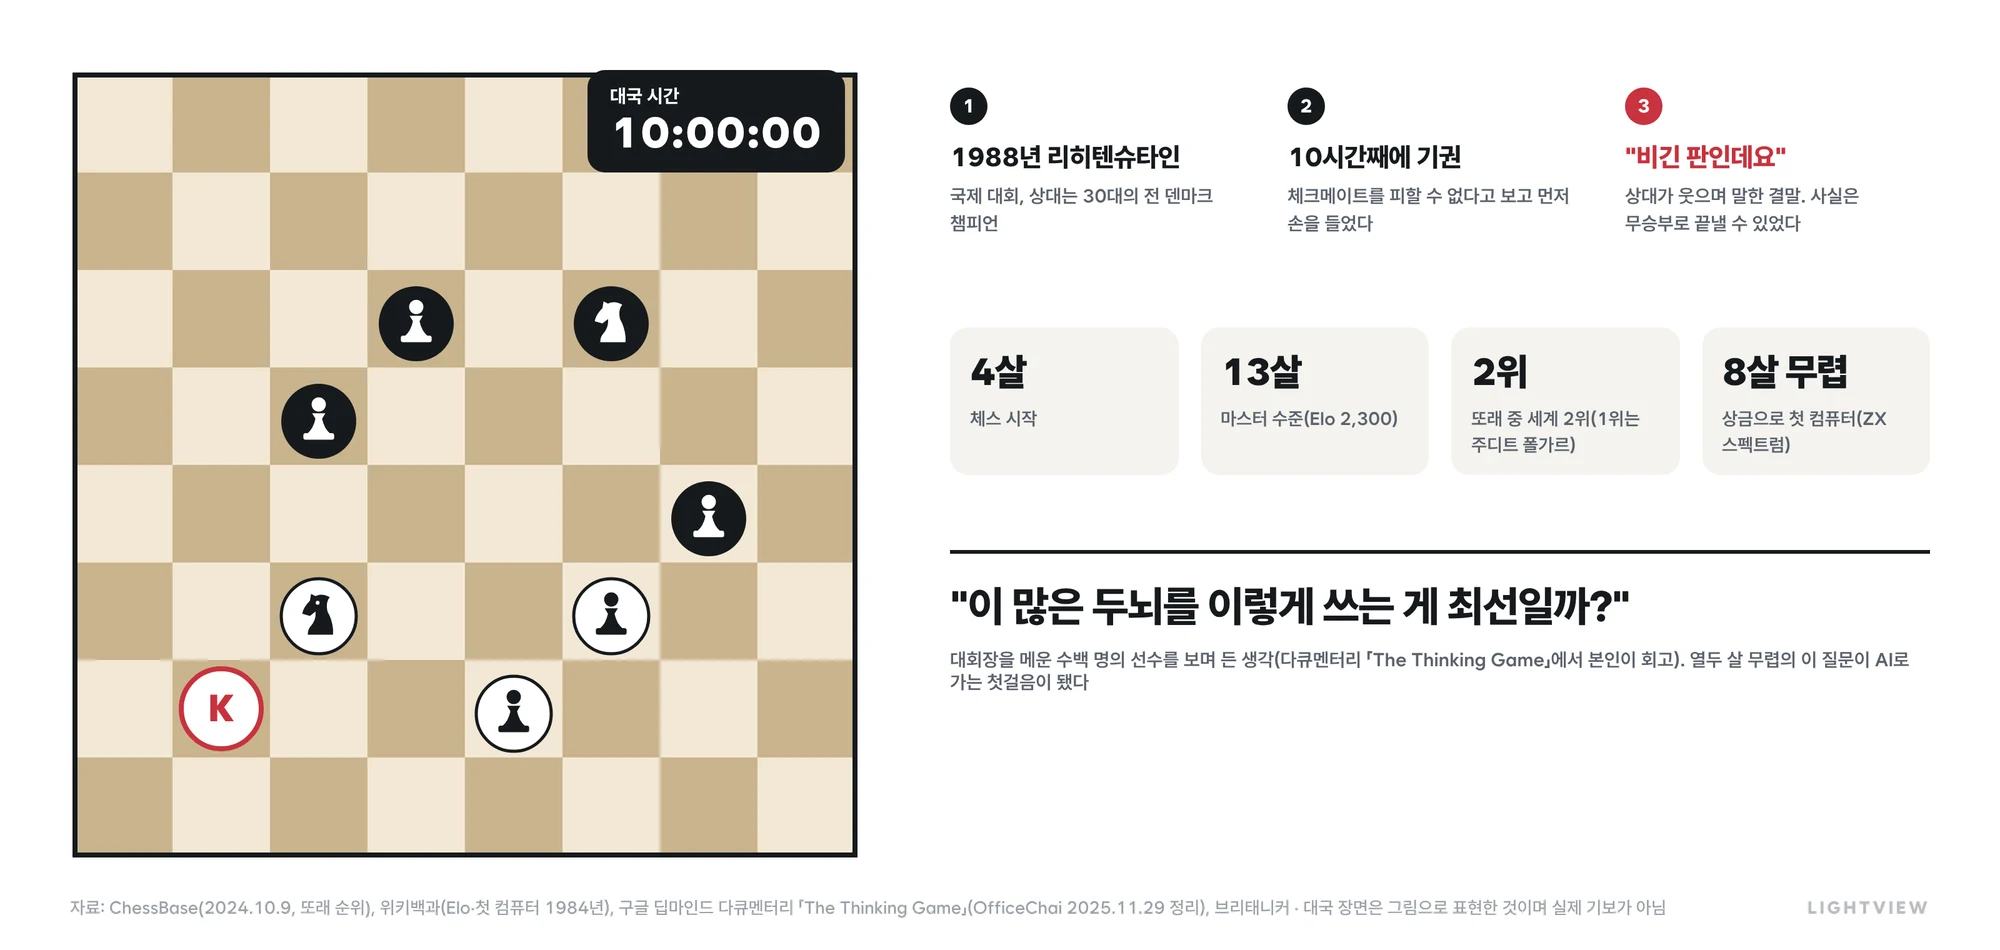
전환점은 1988년 리히텐슈타인의 한 국제 대회였습니다. 30대의 전 덴마크 챔피언과 10시간째 대국을 이어 가던 소년은 체크메이트를 피할 수 없다고 보고 먼저 기권했습니다. 그런데 상대는 "왜 기권하느냐, 비긴 판인데"라고 말했고, 그는 속이 뒤집히는 기분이었다고 회고합니다.
그날 대회장을 메운 수백 명의 선수를 보며 그는 이 뛰어난 두뇌들이 체스판 위에서만 쓰이는 것이 최선인지 묻기 시작했습니다. 그가 더 끌린 것은 체스 자체보다 수를 떠올리는 사고 과정이었습니다. 여덟 살 무렵 체스 상금으로 산 첫 컴퓨터(ZX 스펙트럼)로 독학한 프로그래밍이 그 질문을 풀 도구가 됐습니다.
열한 살 무렵에는 직접 짠 오셀로 게임 프로그램으로 남동생을 이겼다고 회고합니다. 사람이 아니라 자신이 만든 프로그램이 대신 생각해 이겼다는 경험은, 생각하는 기계라는 아이디어를 처음 손에 쥔 순간이었습니다.
잉글랜드 주니어 대표팀 주장을 맡을 만큼 체스 실력은 계속 뛰어났습니다. 하지만 그가 평생 붙잡은 것은 '어떻게 이길까'가 아니라 '이기는 생각은 어디서 오는가'라는 질문이었습니다.
2게임 속 작은 세상을 만들다
체스 다음으로 그가 찾은 무대는 게임이었습니다. 게임은 규칙과 목표가 있는 작은 가상 세계이고, 그 안의 캐릭터가 얼마나 그럴듯하게 움직이느냐가 곧 인공지능의 문제였기 때문입니다.
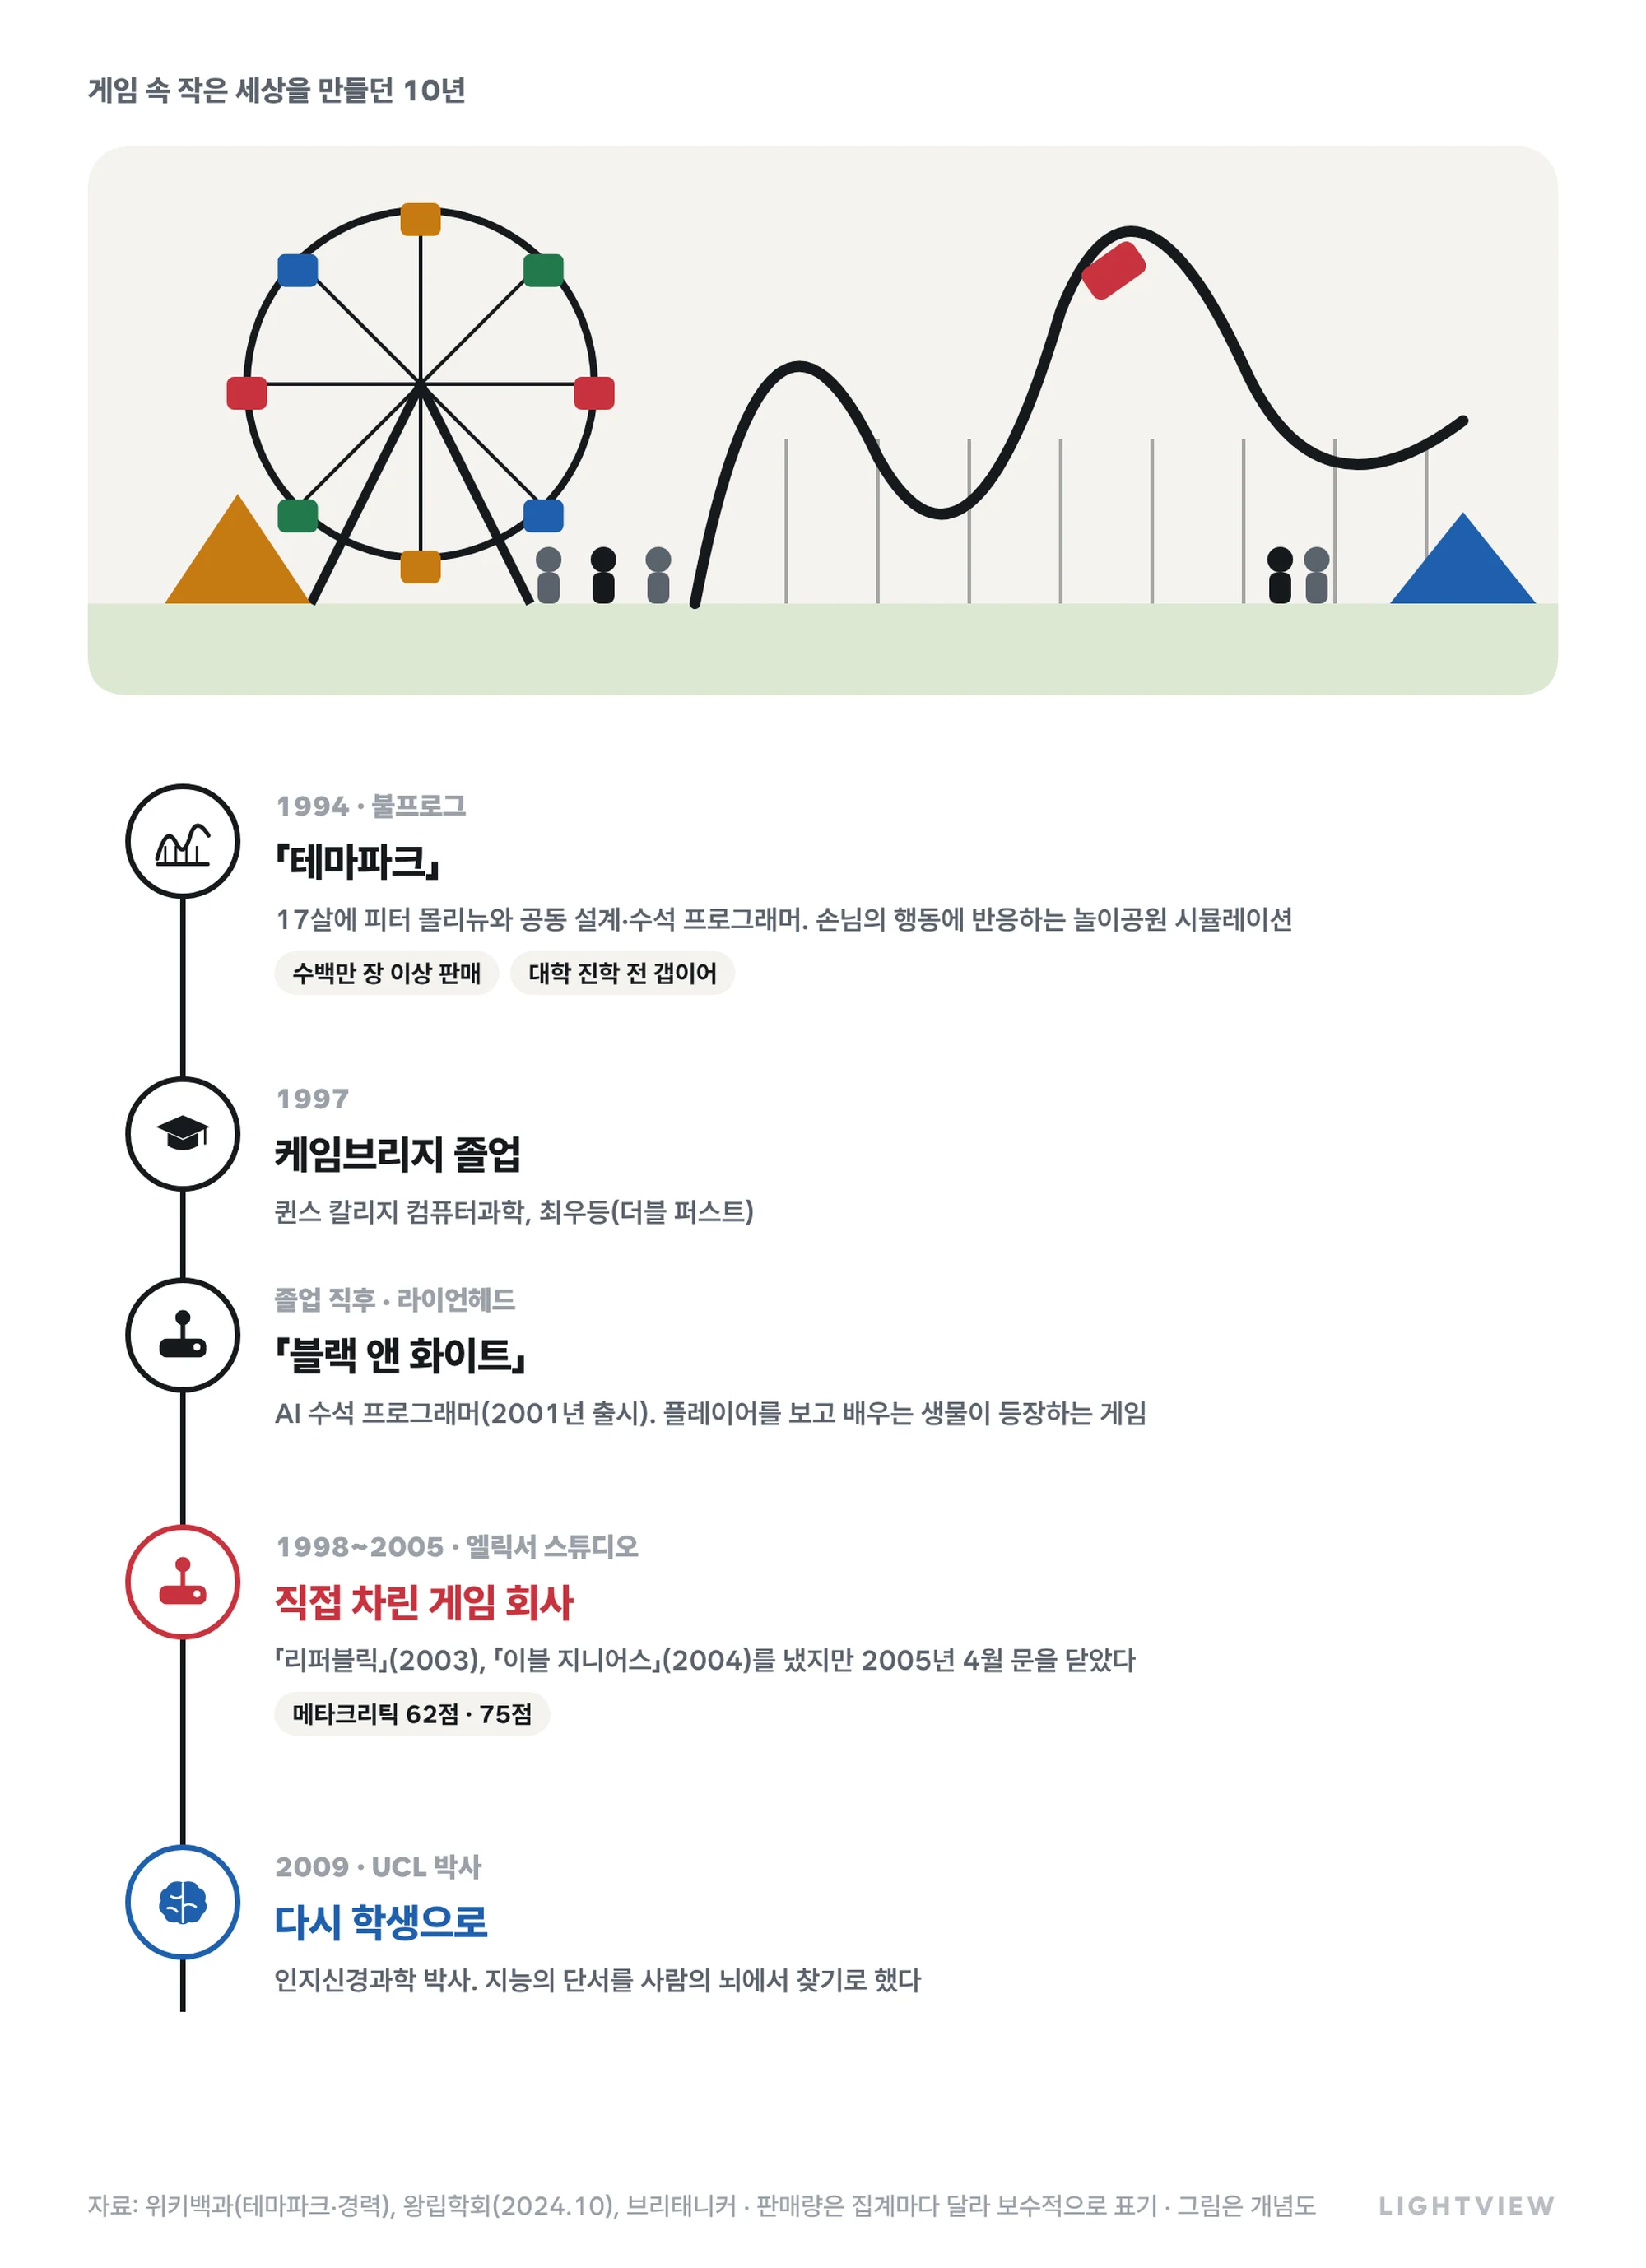
케임브리지대가 입학 전에 1년을 쉬라고 하자 그는 게임 회사 불프로그에 들어갔습니다. 열일곱 살에 전설적인 개발자 피터 몰리뉴와 함께 놀이공원 경영 게임 「테마파크」(1994)를 설계하고 수석 프로그래머를 맡았는데, 손님들이 놀이기구와 매점에 저마다 반응하는 이 게임은 수백만 장 넘게 팔렸습니다. 회사가 거액을 제시하며 붙잡았지만 그는 대학으로 갔습니다.
1997년 컴퓨터과학 최우등으로 졸업한 뒤에는 라이언헤드에서 플레이어를 보고 배우는 생물이 나오는 「블랙 앤 화이트」의 AI를 맡았고, 1998년에는 직접 게임 회사 엘릭서를 차렸습니다. 하지만 엘릭서는 기대만큼의 성공을 거두지 못하고 2005년 4월 문을 닫았습니다.
실패한 창업자는 다시 학생이 됐습니다. 게임 AI를 비롯해 당시 많은 AI는 사람이 규칙을 하나하나 짜 넣는 방식이었는데, 그는 그런 방식으로는 세상의 복잡함을 담을 수 없다고 봤습니다. 실제로 작동하는 범용 지능은 사람의 뇌뿐이었고, 그래서 그는 뇌를 공부하기로 했습니다.
| 게임 시절 | 배운 것 | 딥마인드에서 이어진 것 |
|---|---|---|
| 「테마파크」 | 규칙만 정하면 매번 다른 이야기가 펼쳐지는 시뮬레이션 | 가상 세계 안에서 AI를 훈련 |
| 「블랙 앤 화이트」 | 플레이어를 보고 배우는 생물 | 보상을 보고 스스로 배우는 강화학습 |
| 엘릭서 창업·폐업 | 너무 앞선 목표와 시장의 거리 | 구글이라는 든든한 뒷배를 택한 이유 |
세 번째 열은 라이트뷰가 경력과 이후 행보를 이어 본 해석입니다
「테마파크」가 흥미로운 이유는 정해진 줄거리가 없었다는 점입니다. 개발자는 손님과 놀이기구가 따르는 규칙만 정했고, 플레이어가 공원을 어떻게 꾸미느냐에 따라 매번 다른 일이 벌어졌습니다. 그는 이 경험을 통해 규칙으로 돌아가는 작은 세계, 곧 시뮬레이션의 힘을 몸으로 익혔습니다.
이 감각은 30년 뒤에도 그대로 남아 있습니다. 하편에서 다룰 구글의 '월드 모델'은 AI가 머릿속에 세상을 시뮬레이션하게 하려는 시도인데, 게임 속 작은 세상을 만들던 개발자의 관심이 지능 연구로 옮겨 간 것이라고 볼 수 있습니다.
3기억과 상상은 같은 곳에서
하사비스는 런던대(UCL)에서 인지신경과학을 공부해 2009년 박사 학위를 받았습니다. 그가 붙잡은 주제는 기계가 가장 서툰 두 가지, 기억과 상상이었고, 그 열쇠로 뇌 깊숙한 곳의 해마를 골랐습니다.
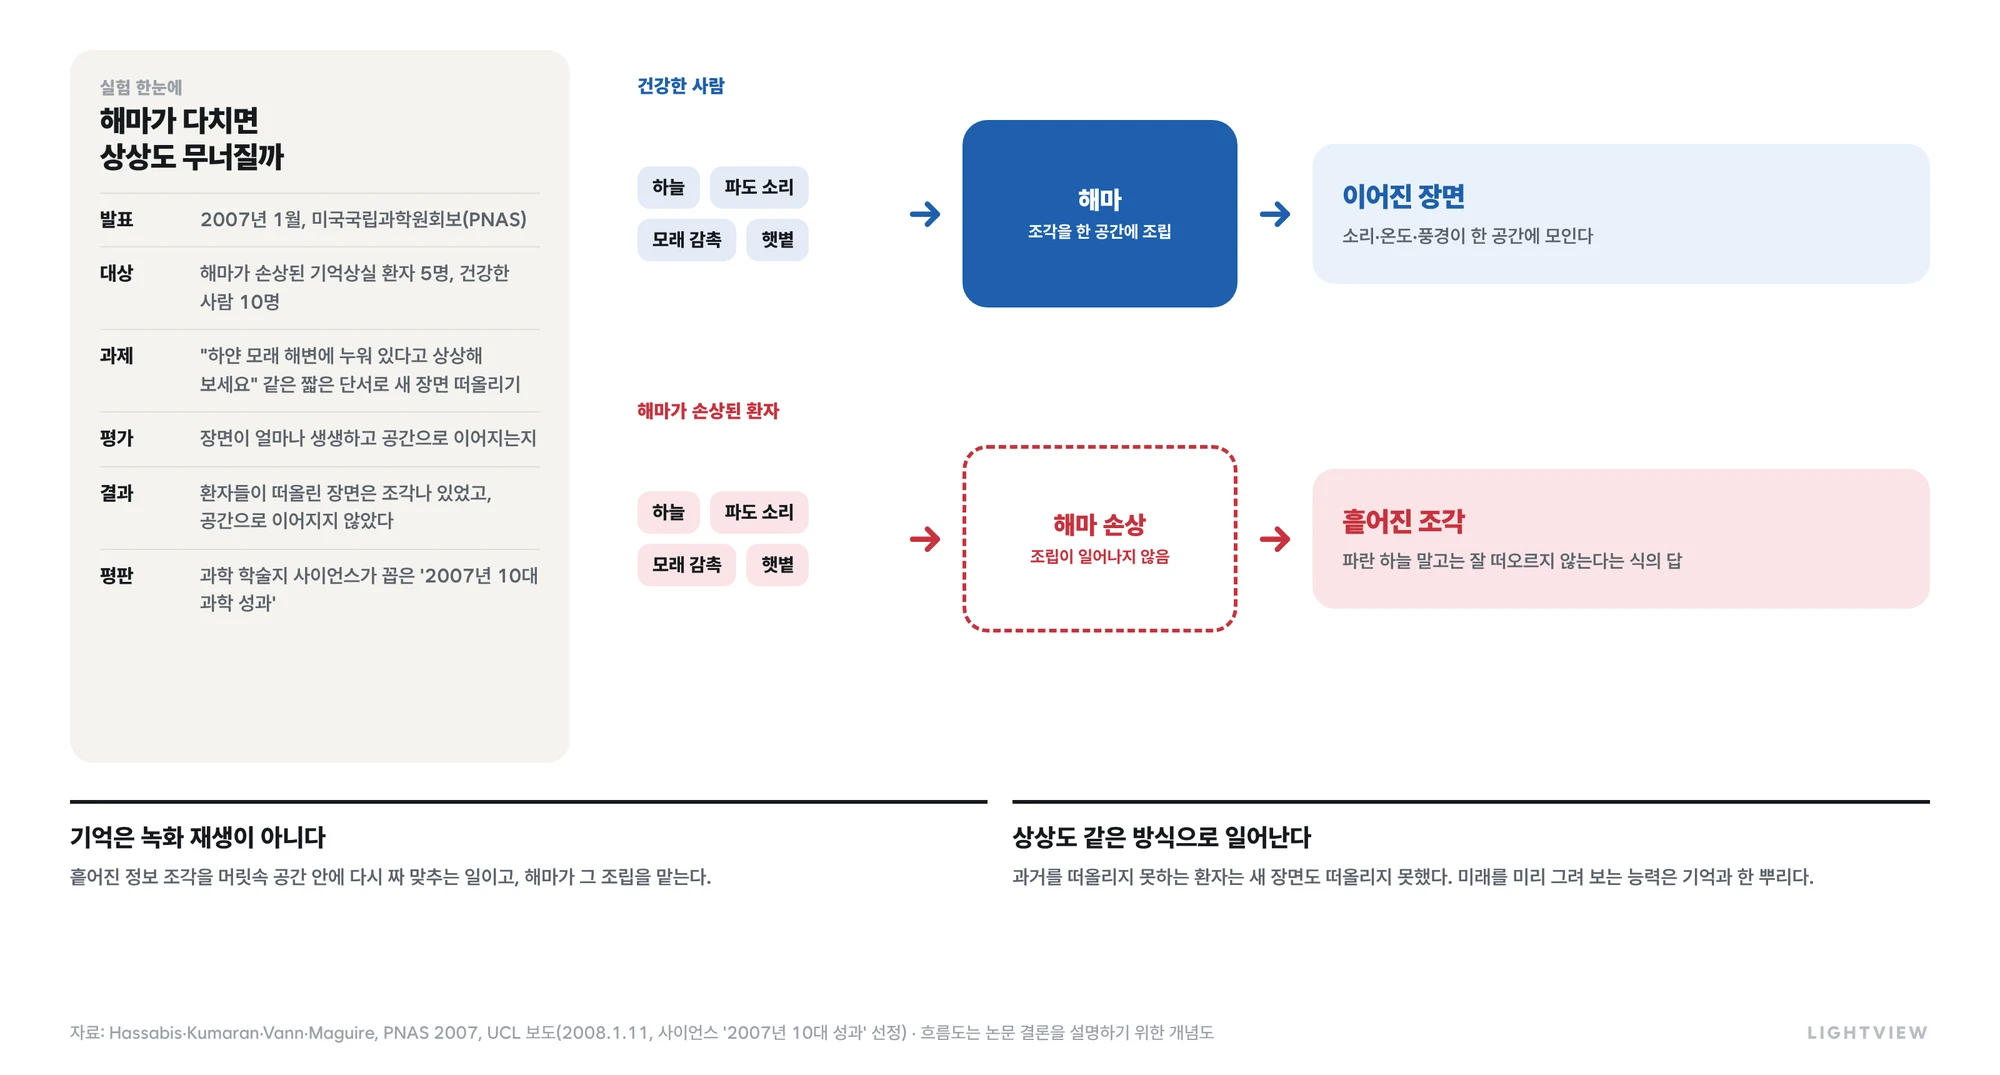
2007년 1월 미국국립과학원회보(PNAS)에 실린 논문에서 연구팀은 해마가 손상된 기억상실 환자 5명과 건강한 사람 10명에게 "하얀 모래 해변에 누워 있다고 상상해 보라" 같은 과제를 줬습니다. 건강한 사람들은 햇볕과 파도 소리, 모래 감촉이 이어진 장면을 그려 냈지만 환자들의 상상은 조각조각 흩어졌습니다.
결론은 기억이 녹화 테이프를 되감는 일이 아니라 조각을 공간 속에 다시 조립하는 일이고, 상상도 같은 방식으로 미래 장면을 미리 그려 보는 일이라는 것이었습니다. 이 연구는 과학 학술지 사이언스가 꼽은 '2007년 10대 과학 성과'에 들었습니다.
| 뇌가 하는 일 | AI로 옮긴 것 | 나온 곳 |
|---|---|---|
| 해마가 낮에 겪은 장면을 다시 꺼내 보며 기억을 다진다 | 지난 게임 장면을 저장해 두었다가 다시 꺼내 배우는 '경험 재생' | DQN(2015, 5장) |
| 조각을 한 공간에 조립해 아직 없는 장면을 그린다 | AI가 머릿속에 세상을 그리고 그 안에서 미리 시험해 보는 '월드 모델' | 지니 등(하편) |
DQN 논문(Nature 2015)은 경험 재생의 아이디어를 해마의 기억 재생에서 가져왔다고 밝혔습니다
4규칙을 알려 주지 않은 게임
박사후 연구를 하던 UCL 연구소에서 그는 셰인 레그를 만났고, 어릴 때부터 알던 동생의 친구 무스타파 술레이만과 함께 2010년 딥마인드를 세웠습니다. 세 사람의 목표는 특정 업무를 잘하는 프로그램이 아니라 무엇이든 스스로 배우는 범용 지능이었습니다.
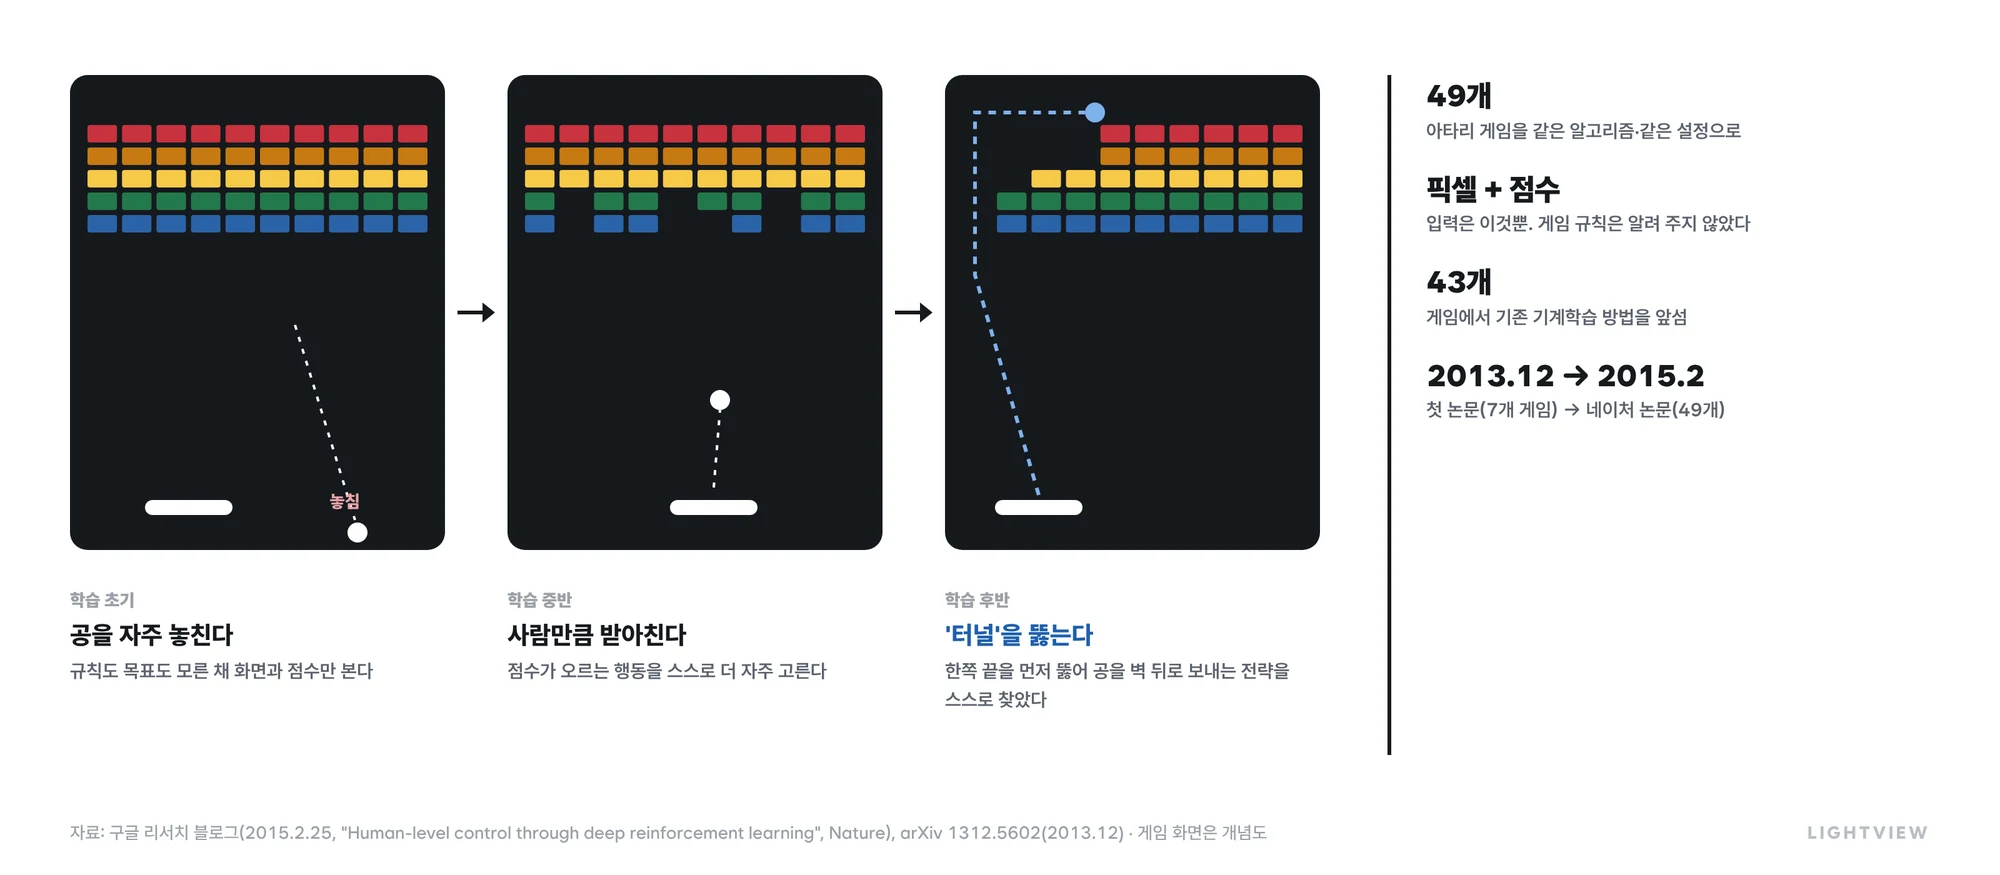
첫 훈련장은 비디오 게임이었습니다. 이기고 지는 결과가 바로 나오고, 셀 수 없이 다시 해 볼 수 있기 때문입니다. 2013년 12월 게임 7개로 첫 논문을 낸 'DQN'은 2015년 2월 네이처 논문에서 화면 픽셀과 점수만 보고 아타리 게임 49개를 같은 방식으로 배워 43개에서 기존 방법을 앞섰습니다. 벽돌 깨기에서는 벽 한쪽을 먼저 뚫어 공을 벽 뒤로 보내는 요령까지 스스로 익혔습니다.
| 시기 | 일어난 일 |
|---|---|
| 2010 | 런던에서 설립. 초기 투자자 파운더스 펀드(피터 틸), 호라이즌스 벤처스, 일론 머스크, 얀 탈린 등 |
| 2013.12 | 아타리 게임을 스스로 배우는 AI(DQN) 논문 초안 공개 |
| 2014.1 | 구글이 인수(보도 기준 4억~6억 달러대). 윤리위원회 설치가 조건이었다는 보도 |
| 2015.2 | DQN 논문 네이처 게재, 49개 게임 중 43개에서 기존 방법을 앞섬 |
5구글을 택하고, 서울에서 증명하다
2014년 1월 구글은 딥마인드를 인수했습니다. 금액은 공식 발표되지 않았지만 보도 기준 4억~6억 달러대였고, 딥마인드는 앞서 페이스북의 접근을 거절한 것으로 알려졌습니다. 내부 윤리위원회를 만드는 것이 인수 조건이었다는 보도도 있습니다.
하사비스는 구글의 컴퓨팅 인프라를 혼자 따라잡으려면 10년은 걸렸을 것이라고 말한 적이 있습니다. 투자 유치와 사업화에 시간을 쓰는 스타트업 대표 대신 연구에 집중할 수 있는 환경도 구글을 택한 이유로 풀이됩니다.
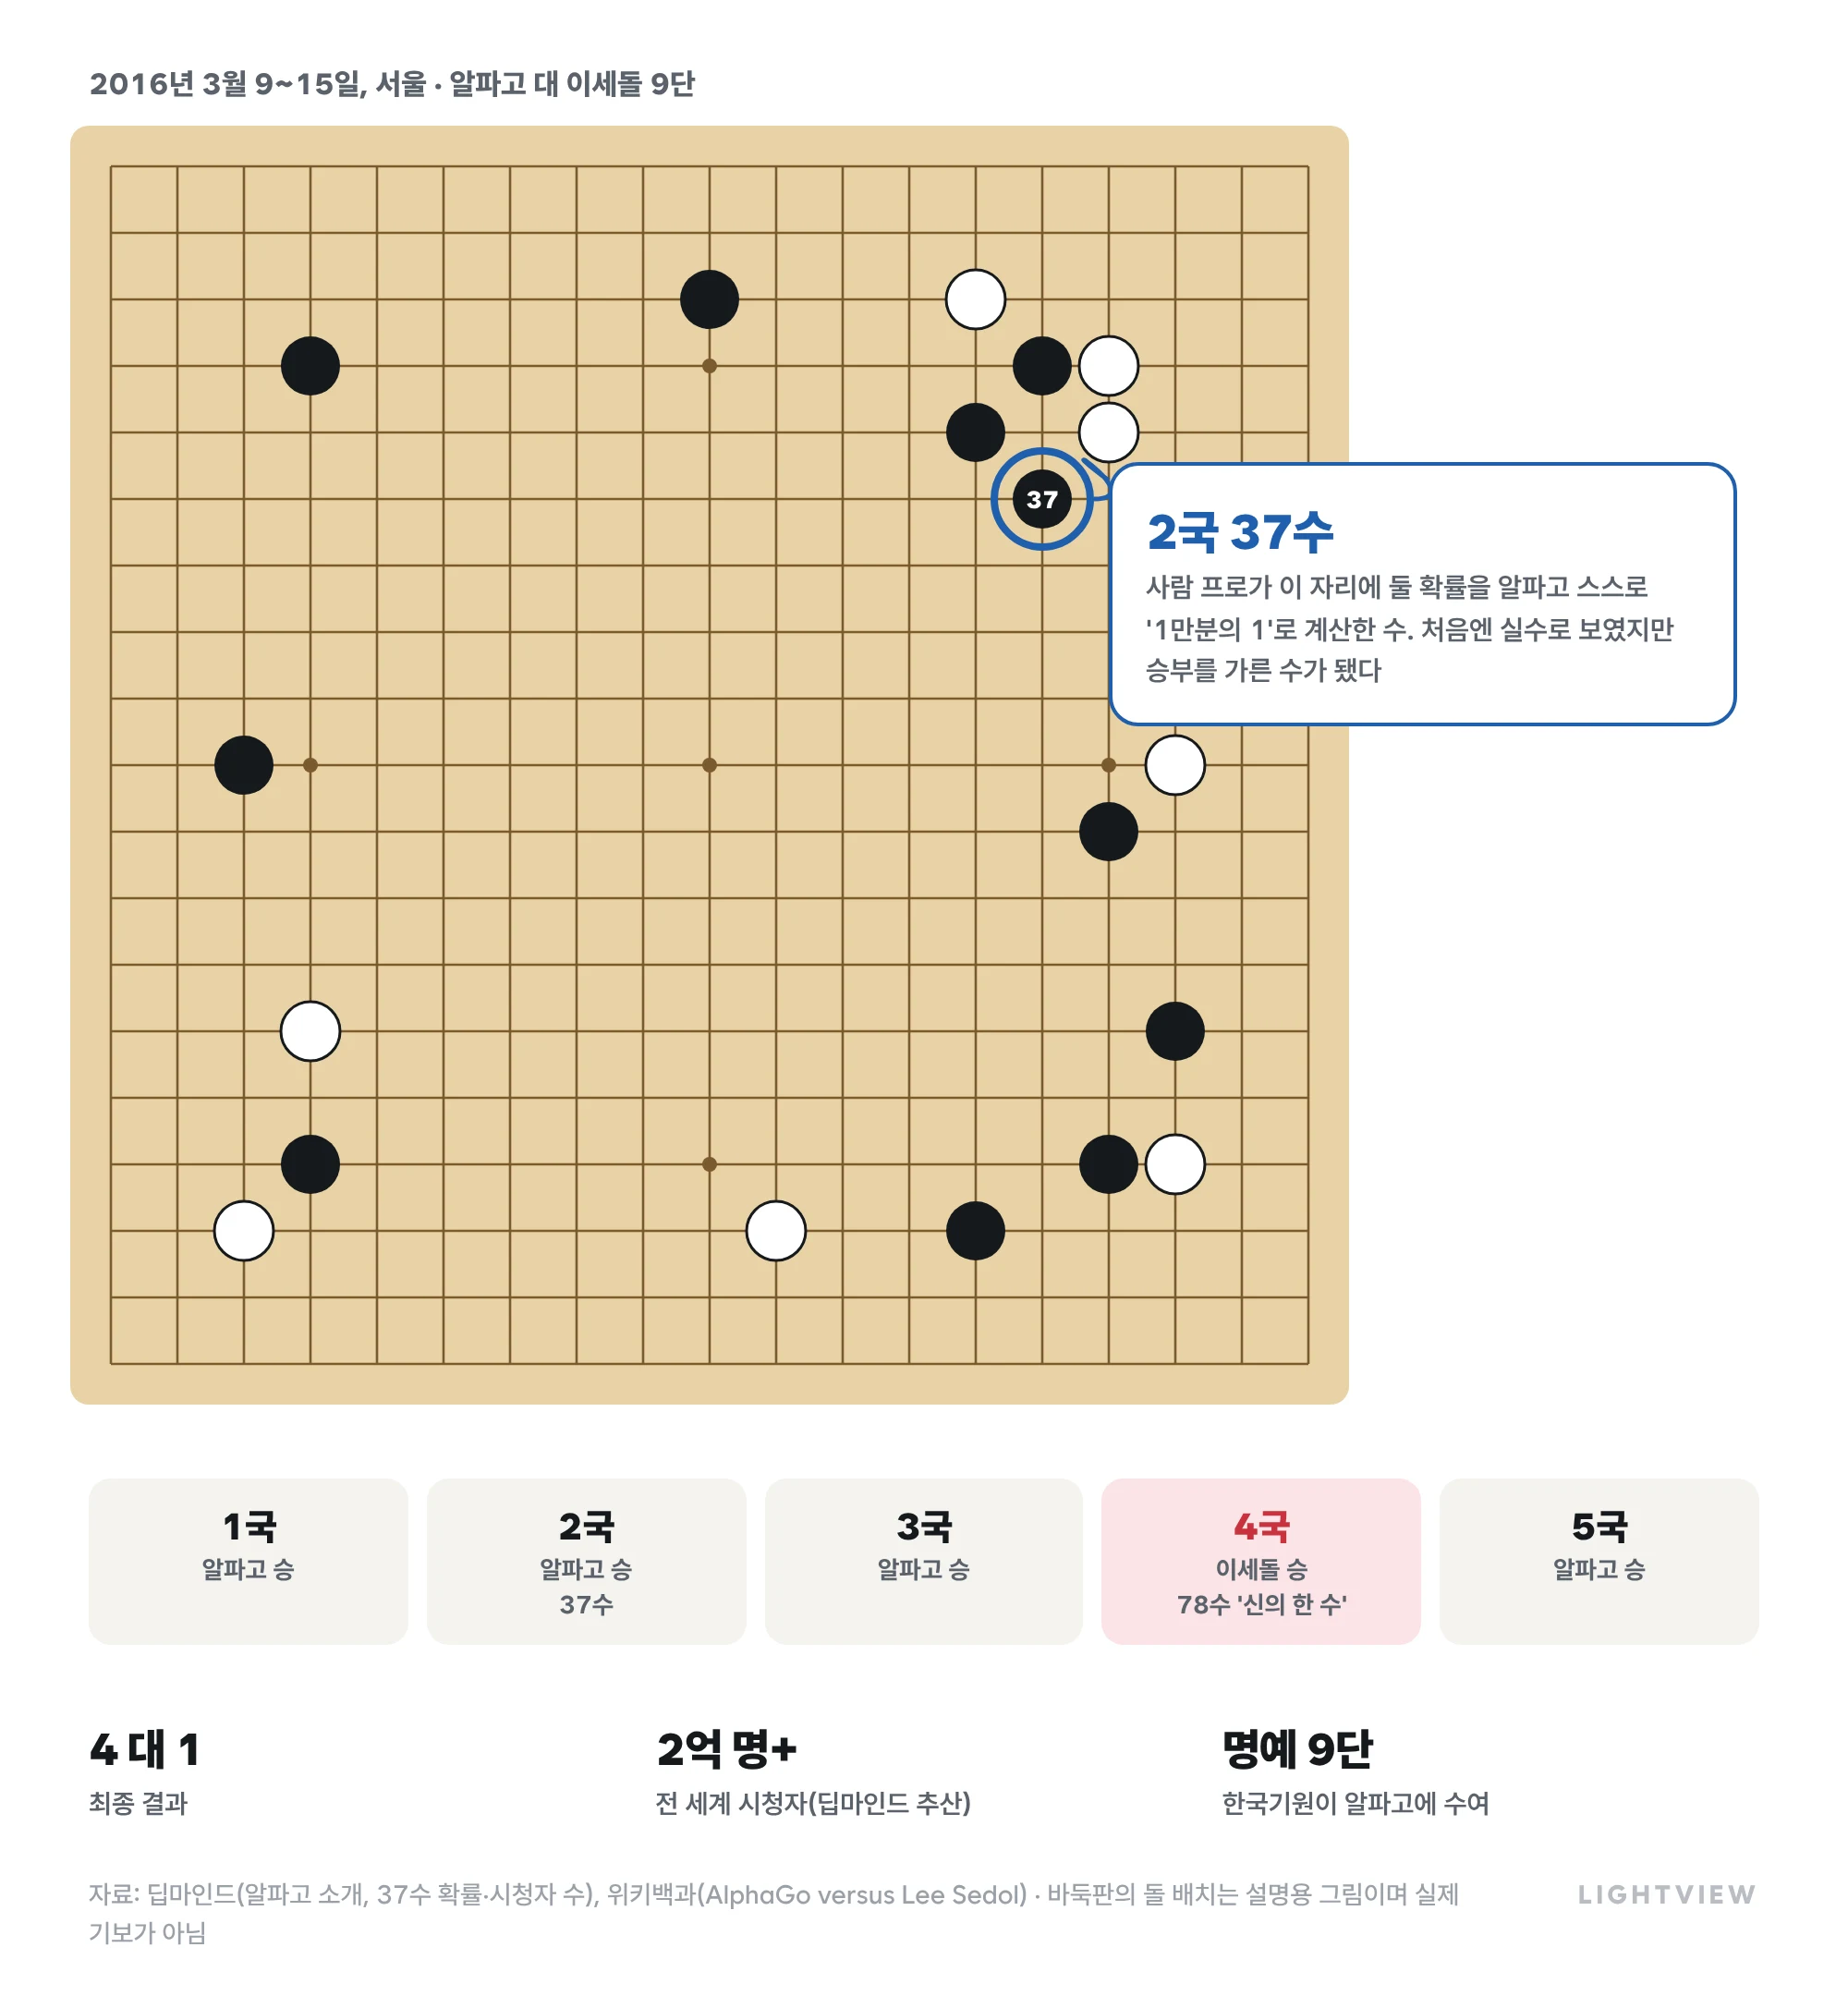
2년 뒤 그 선택은 서울에서 결과를 냈습니다. 2016년 3월 알파고는 이세돌 9단을 4대 1로 이겼고, 2국의 37수는 사람 프로가 둘 확률을 알파고 스스로 1만분의 1로 본 수였습니다. 이세돌 9단은 4국 78수로 한 판을 따냈고, 이 대국은 전 세계 2억 명 넘게 지켜봤습니다.
알파고의 의미는 이긴 데 있지 않았습니다. 사람의 기보로 기초를 익힌 뒤 스스로 수많은 대국을 두며 실력을 키웠고, 그 과정에서 사람이 생각하지 못한 수를 찾아냈다는 점이 핵심이었습니다.
| 상대 | 시기 | 결과 | 메모 |
|---|---|---|---|
| 판후이 2단(유럽 챔피언) | 2015.10 | 5 대 0 | 프로 기사를 처음 이긴 컴퓨터 |
| 이세돌 9단 | 2016.3 | 4 대 1 | 서울, 2억 명 넘게 시청 |
| 온라인 고수들('마스터') | 2016.12~2017.1 | 60 대 0 | 정체를 숨기고 온라인 대국 |
| 커제 9단 | 2017.5 | 3 대 0 | 중국 우전, 당시 세계 1위 |
자료: 딥마인드, 위키백과(AlphaGo versus Lee Sedol·Ke Jie·Master) · 이세돌 9단은 2019년 11월 은퇴하며 "내가 1위가 되더라도 이길 수 없는 존재가 있다"고 말했다
바둑이 AI의 시험대가 된 데에는 이유가 있습니다. 바둑판 위에 나올 수 있는 배치의 수는 약 10의 170제곱으로, 관측 가능한 우주의 원자 수(약 10의 80제곱)보다 훨씬 많습니다. 체스 프로그램처럼 수를 넓고 깊게 읽는 방식만으로는 풀기 어렵고, 직관에 가까운 판단이 필요하다는 뜻입니다.
알파고는 다음 수를 고르는 신경망과 형세를 판단하는 신경망을 함께 쓰고, 유망한 수만 골라 깊이 내다봤습니다. 계산 능력이 아니라 '판단하는 법'을 배운 기계였다는 점에서, 하사비스가 말해 온 범용 지능에 한 걸음 다가선 사건이었습니다.
6사람의 기보를 버리다
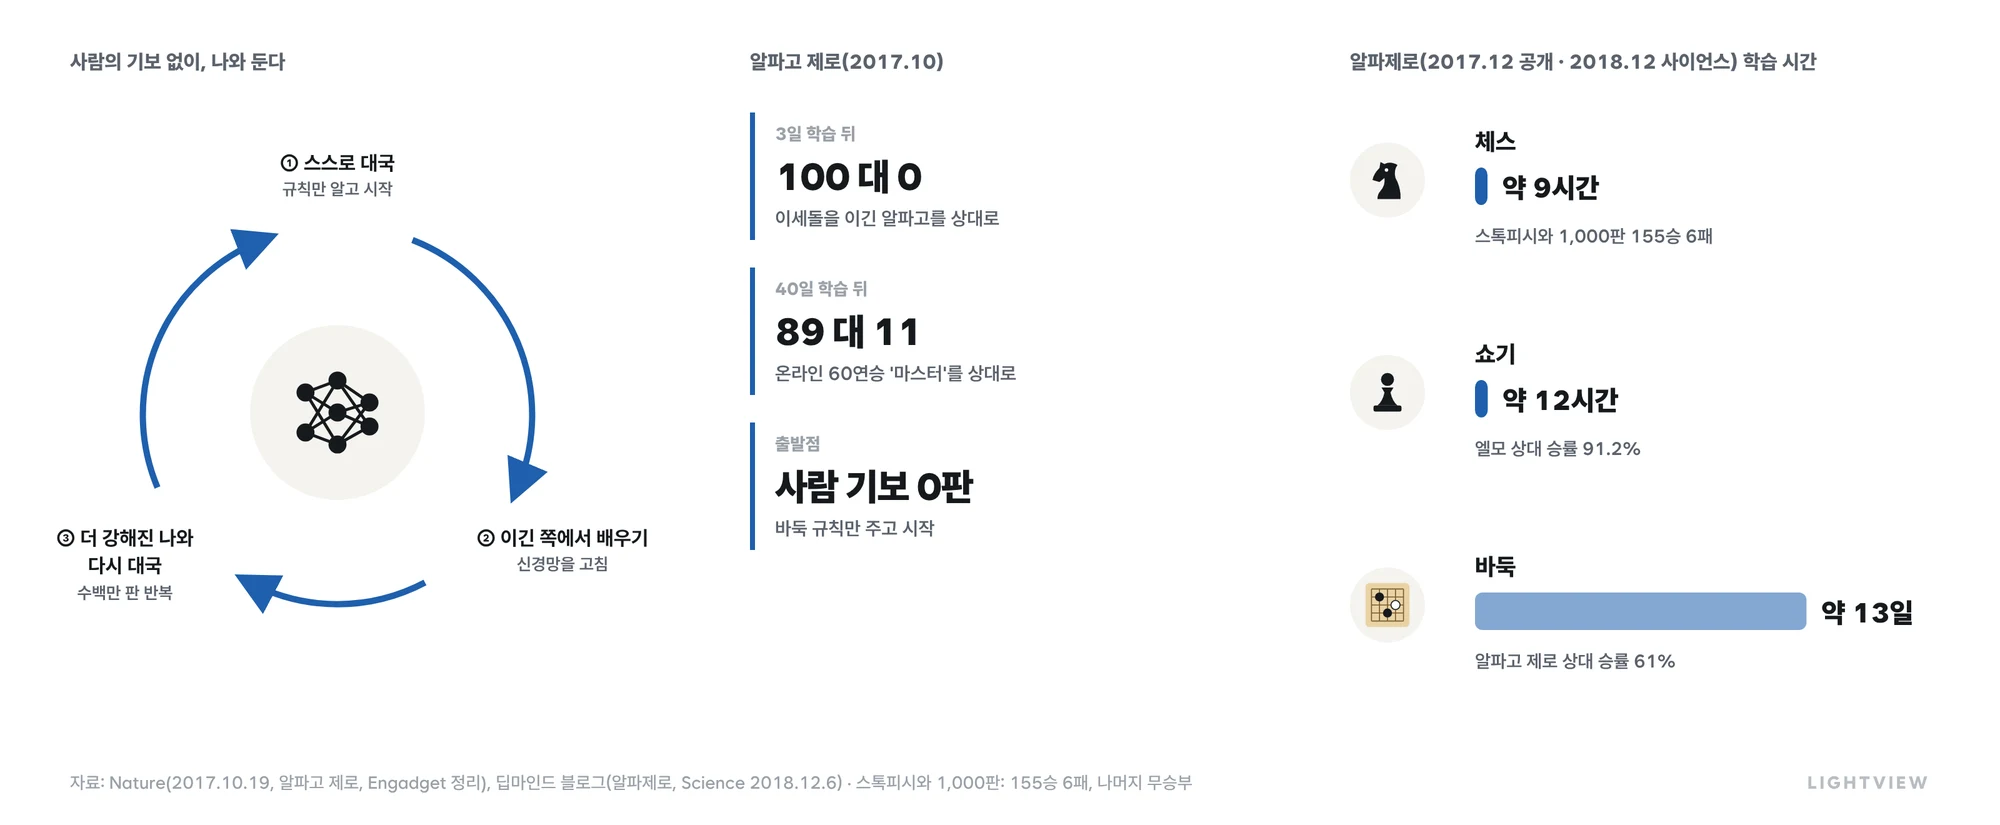
딥마인드는 한 걸음 더 나갔습니다. 2017년 10월 공개한 알파고 제로는 사람의 기보를 한 판도 보지 않고 바둑 규칙만으로 출발했습니다. 스스로 대국하며 배운 지 사흘 만에 이세돌을 이긴 알파고를 100대 0으로 꺾었고, 40일 뒤에는 온라인 60연승을 거둔 '마스터'마저 89대 11로 넘어섰습니다.
같은 해 12월 공개한 알파제로는 한 가지 방법으로 체스·쇼기·바둑을 모두 익혔습니다. 2018년 사이언스 논문에서는 약 9시간 학습한 체스로 최강 체스 프로그램 스톡피시와 1,000판을 둬 155승 6패를 기록했습니다. 리히텐슈타인의 그 대국에서 30년 가까이 지나, 그가 만든 AI가 체스의 정상에 선 셈입니다.
| 이름 | 공개 | 무엇을 했나 | 의미 |
|---|---|---|---|
| DQN | 2013~2015 | 아타리 게임 49개를 픽셀과 점수만으로 학습 | 하나의 방법으로 여러 과제 |
| 알파고 | 2016 | 이세돌 9단에 4대 1 | 사람이 못 본 수를 찾음 |
| 알파고 제로 | 2017 | 사람 기보 없이 3일 만에 알파고에 100대 0 | 사람의 지식 없이도 넘어섬 |
| 알파제로 | 2017~2018 | 체스·쇼기·바둑을 한 방법으로 | 범용성 |
| 알파스타 | 2019 | 스타크래프트 II 상위 0.2%(그랜드마스터) | 정보가 가려진 실시간 게임 |
자료: Nature(2015.2, 2017.10), Science(2018.12), Nature(2019.10, 알파스타), 딥마인드 블로그
다만 게임에는 분명한 한계가 있었습니다. 규칙이 정확하고, 이기고 지는 결과가 바로 나오고, 몇백만 번이라도 다시 해 볼 수 있다는 점입니다. 현실의 과학 문제는 그렇지 않습니다. 실험 한 번에 몇 달이 걸리고 정답을 바로 확인할 수도 없습니다. 그래서 하사비스는 게임에서 단련한 방법을 들고 정답을 확인할 수 있는 과학 문제를 찾아 나섰습니다.
750년 묵은 문제를 풀다
게임은 연습이었습니다. 하사비스가 처음부터 겨냥한 것은 과학의 난제였고, 첫 과녁은 단백질 구조 예측이었습니다. 단백질은 아미노산이 줄줄이 이어진 사슬인데, 이 사슬이 어떤 입체 모양으로 접히느냐에 따라 몸속에서 하는 일이 달라집니다.
모양을 알아야 하는 이유는 약에 있습니다. 질병을 일으키는 단백질의 모양을 알면 약 분자가 달라붙을 자리를 찾을 수 있고, 새 효소나 백신을 설계하는 일도 빨라집니다. 문제는 모양을 알아내기가 너무 어렵다는 점이었습니다. 1972년 노벨 화학상을 받은 크리스천 안핀슨이 아미노산 서열이 모양을 정한다는 사실을 밝힌 뒤로, 과학자들은 서열만 보고 모양을 계산해 보려 했지만 번번이 실패했습니다. 결국 실험으로 하나씩 밝혀야 했고, 단백질 하나에 몇 년이 걸리기도 했습니다.
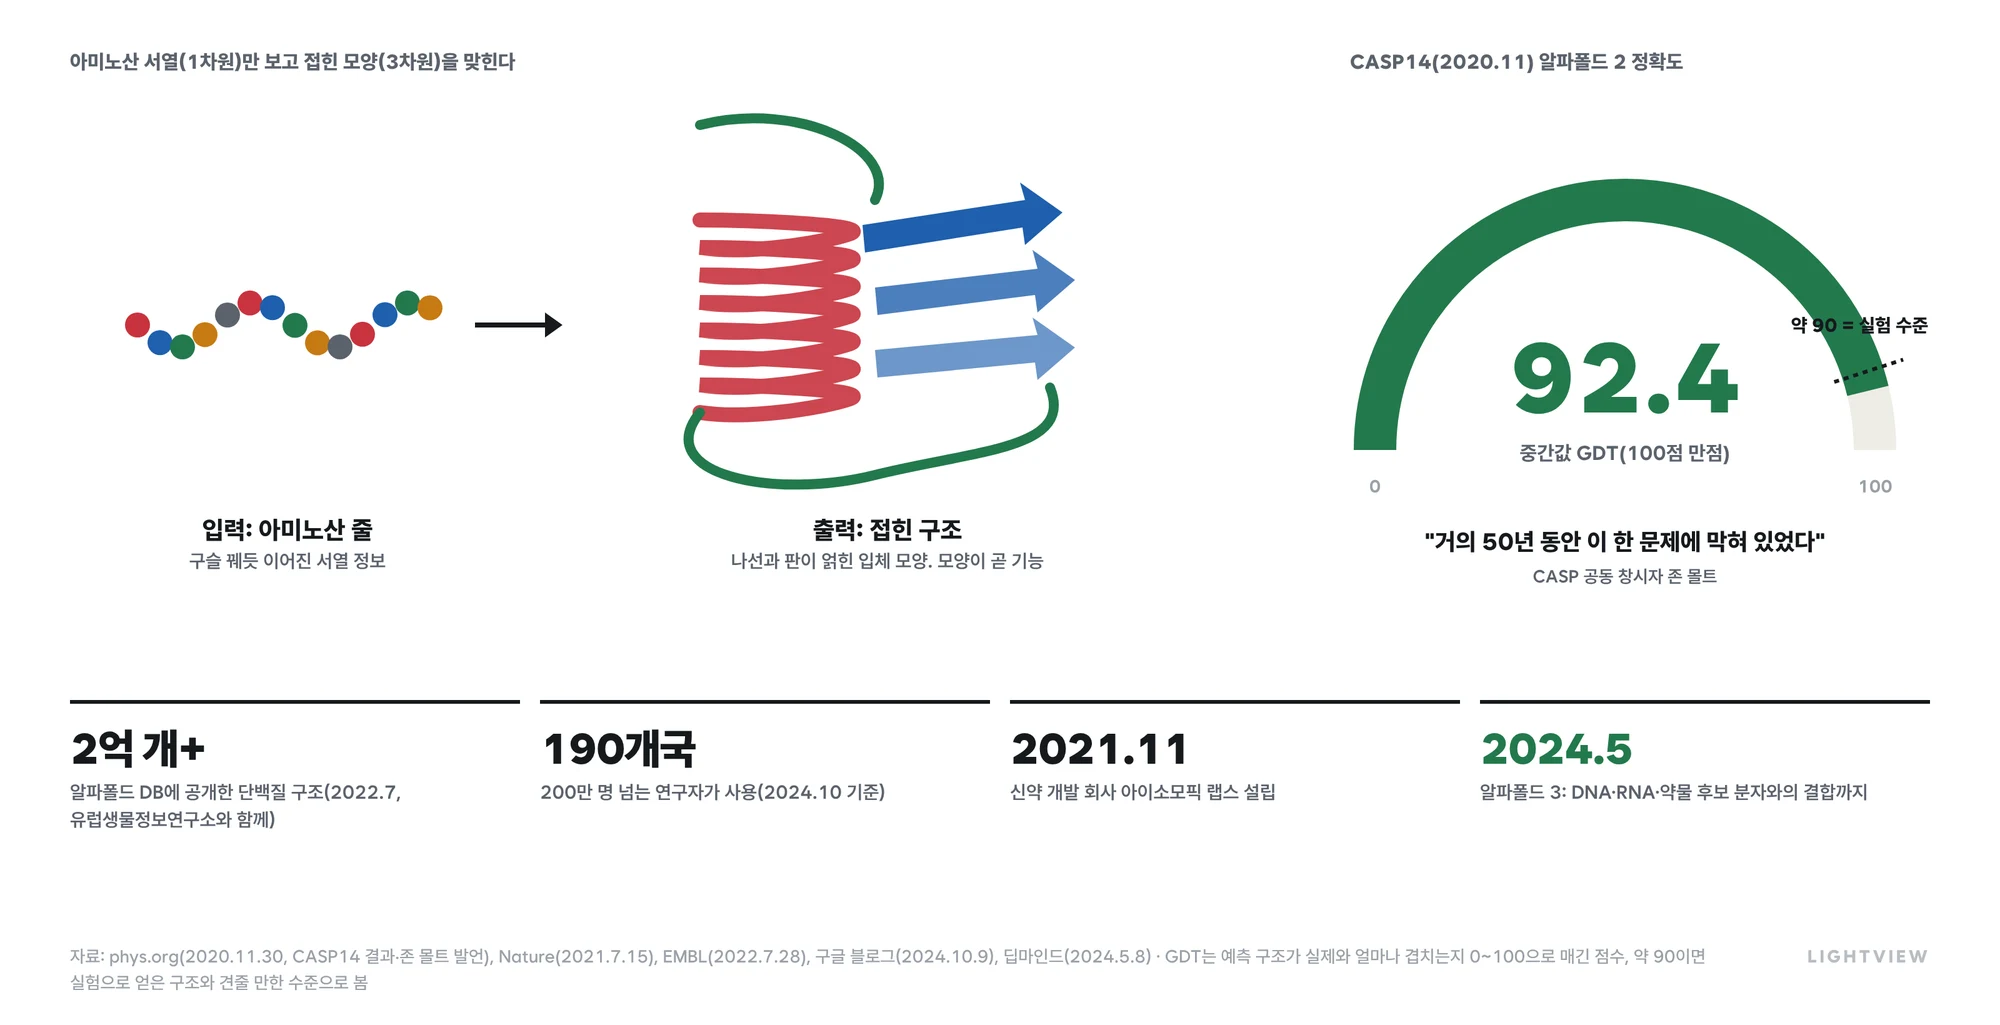
알파폴드는 이 문제를 겨루는 2년마다의 예측 대회(CASP)에서 2018년 1위에 올랐고, 2020년 11월에는 알파폴드 2로 중간값 92.4점을 기록했습니다. 90점 안팎이면 실험으로 얻은 구조와 견줄 만한 수준입니다. 대회를 만든 과학자의 반응이 이 결과의 무게를 보여 줍니다.
딥마인드는 이 결과를 혼자 쥐고 있지 않았습니다. 예측한 구조 2억 개 이상을 누구나 쓸 수 있게 풀었고, 직접 신약 개발에 나설 회사 아이소모픽 랩스를 따로 세웠습니다. 딥마인드는 말라리아 백신, 플라스틱 분해 효소 같은 연구에 이 구조들이 쓰인 사례를 소개하고 있습니다.
물론 알파폴드가 모든 것을 푼 것은 아닙니다. 단백질이 움직이며 모양을 바꾸는 과정이나 여러 분자가 얽히는 복잡한 상황은 여전히 어렵고, 예측 결과는 실험으로 다시 확인해야 합니다. 그래도 몇 년 걸리던 첫 단계를 컴퓨터 계산으로 크게 줄였다는 점에서, 과학을 하는 방식 자체가 달라졌다는 평가가 많습니다.
8노벨상, 그리고 남은 질문
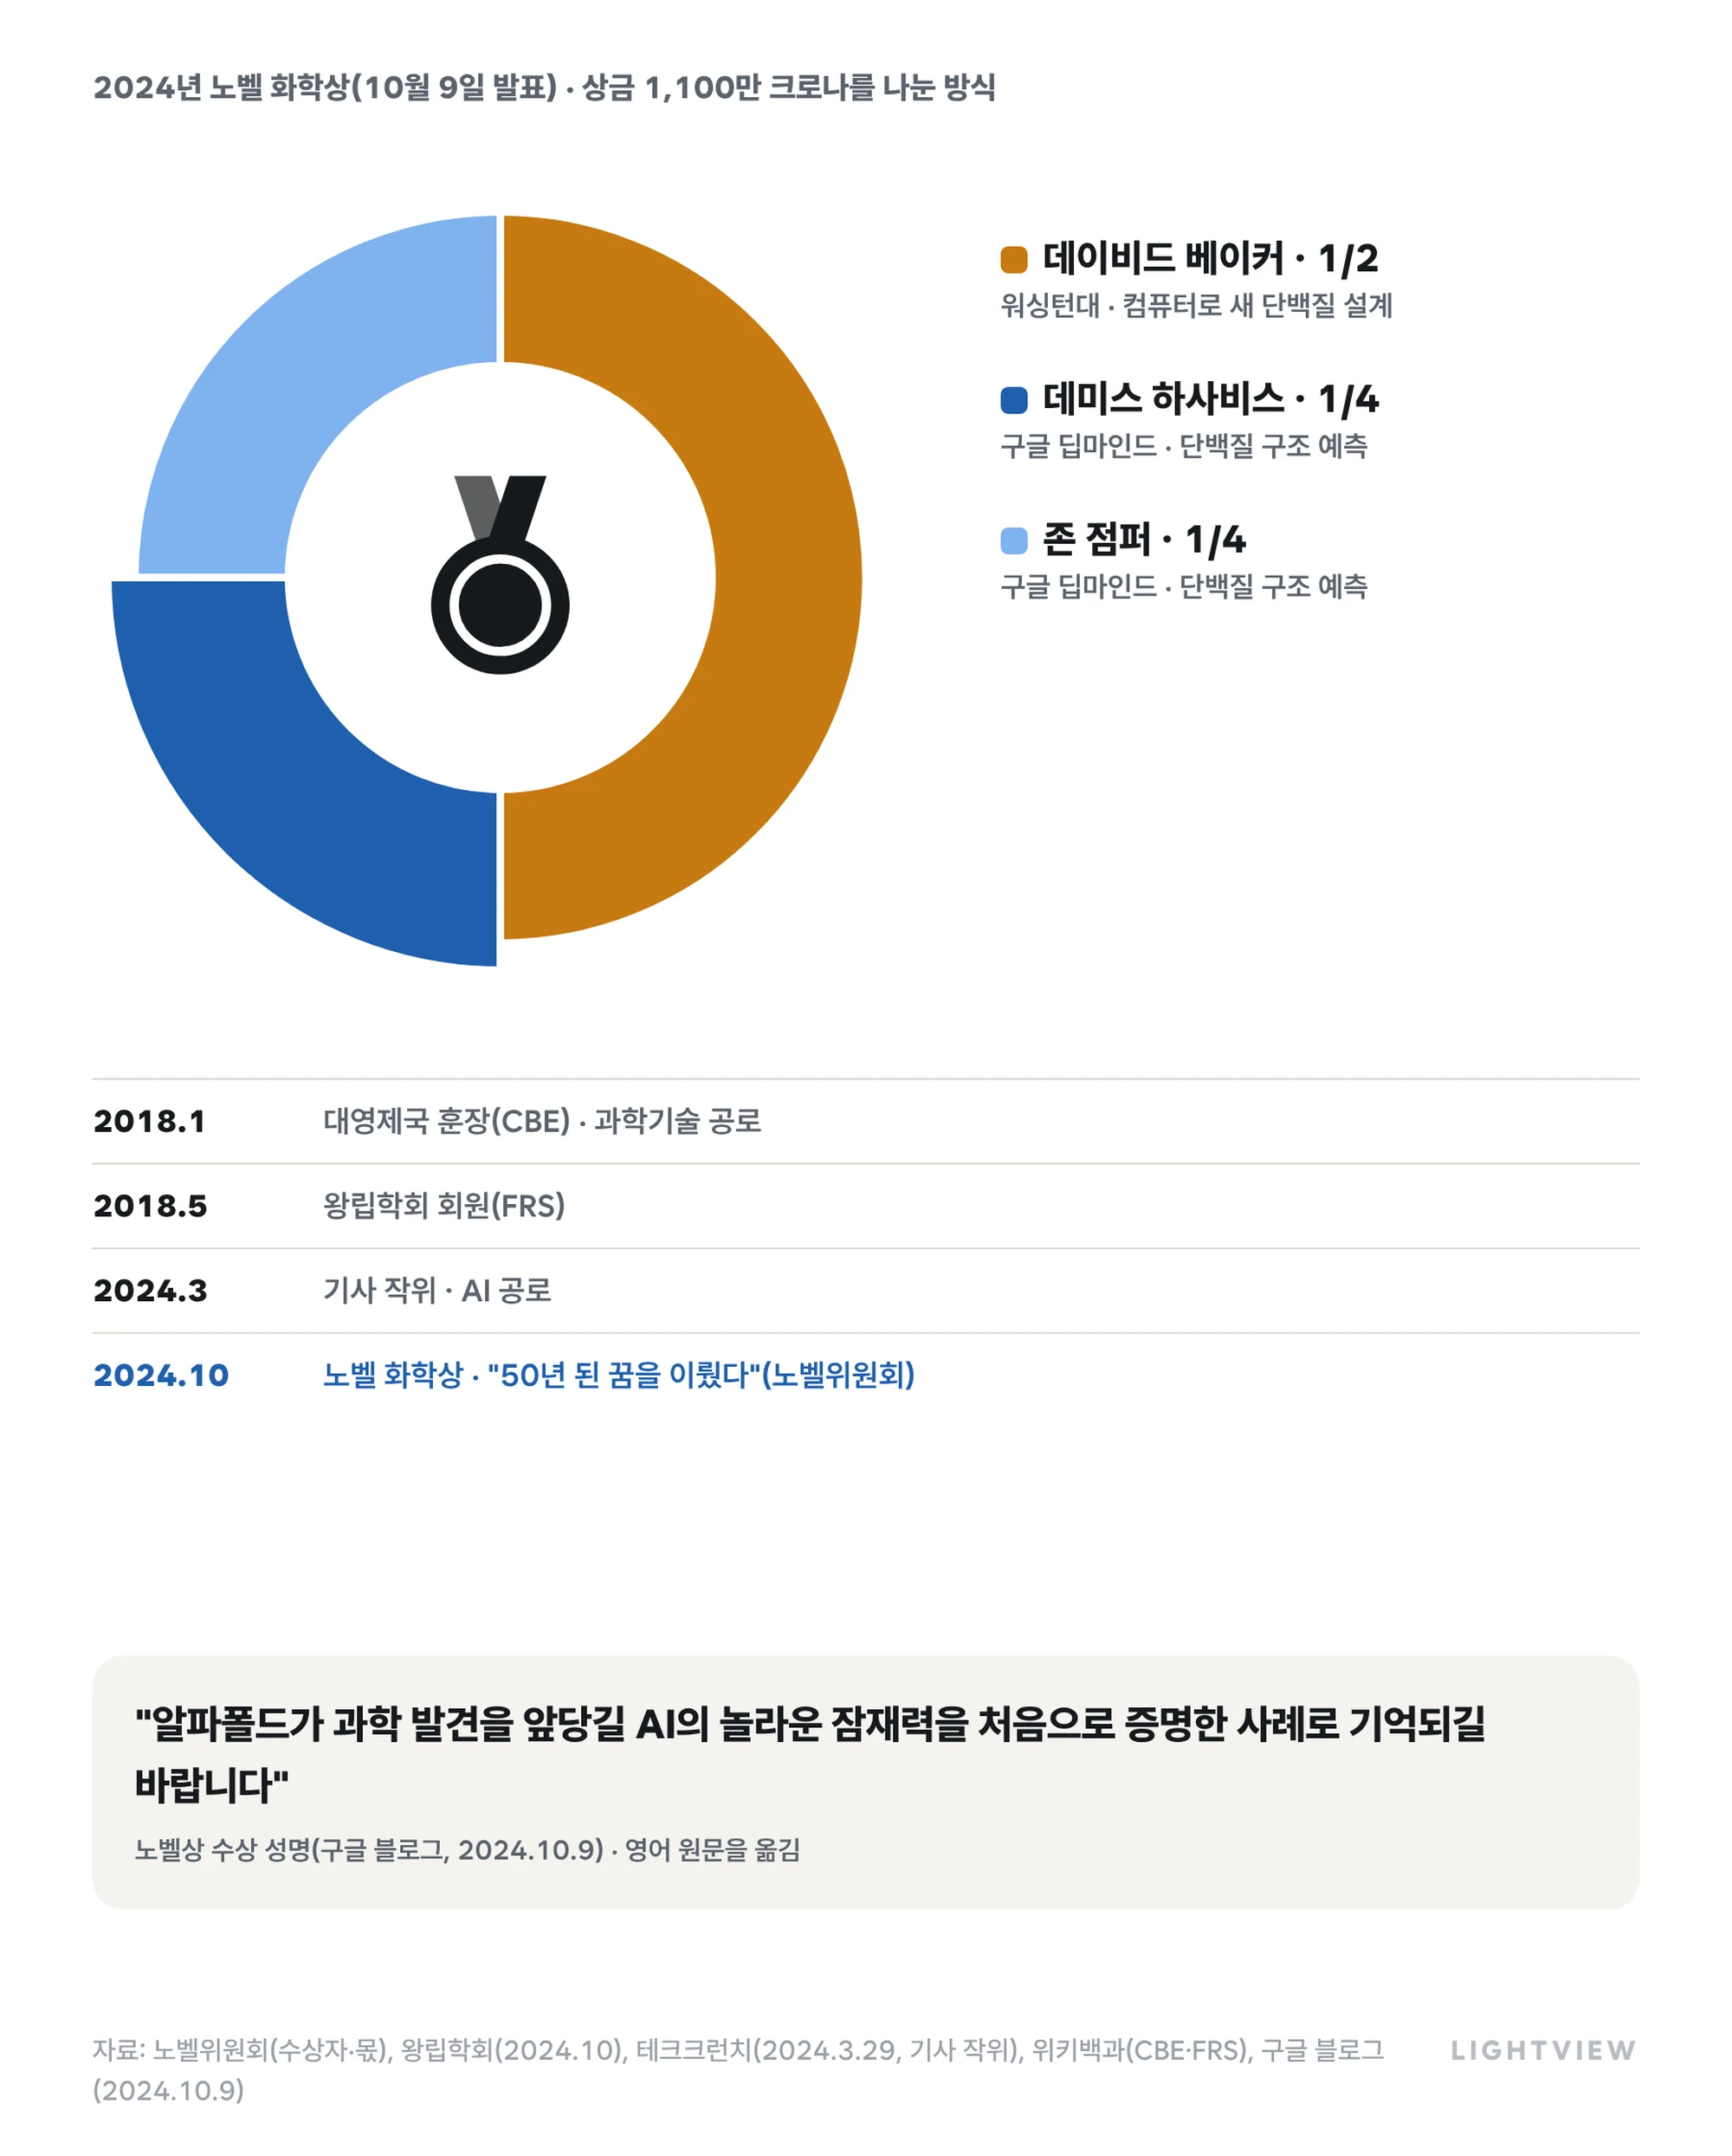
2024년 10월 9일, 스웨덴 왕립과학원은 노벨 화학상의 절반을 데이비드 베이커에게, 나머지 절반을 하사비스와 존 점퍼에게 줬습니다. 노벨위원회는 알파폴드가 "아미노산 서열로 단백질 구조를 예측하는 50년 된 꿈을 이뤘다"고 평가했습니다.
체스판의 소년이 품은 질문은 30여 년 만에 과학의 가장 높은 자리에 닿았습니다. 그해 3월에는 AI 공로로 영국 기사 작위도 받았습니다. 그는 수상 성명에서 알파폴드가 과학 발견을 앞당길 AI의 잠재력을 처음 증명한 사례로 기억되길 바란다고 말했습니다.
그러나 노벨상을 받던 무렵, 그가 이끄는 구글은 전혀 다른 전장에서 고전하고 있었습니다. 2022년 11월 오픈AI가 내놓은 챗GPT가 AI의 주도권을 과학 연구실에서 소비자의 스마트폰으로 옮겨 놓았기 때문입니다.
+더 알아 둘 용어와 출처
용어
- 노벨위원회 수상자 정보(출생) · 브리태니커(Demis Hassabis) · ChessBase(2024.10.9, 또래 순위) · 구글 딥마인드 다큐멘터리 「The Thinking Game」(OfficeChai 2025.11.29 정리, 리히텐슈타인 대국) · 위키백과(첫 컴퓨터·테마파크·엘릭서) · 왕립학회(2024.10, 테마파크 17살)
- Hassabis·Kumaran·Vann·Maguire, "Patients with hippocampal amnesia cannot imagine new experiences", PNAS(2007.1) · UCL 보도(2008.1.11, 사이언스 2007년 10대 성과) · Mnih 외, Nature(2015, 경험 재생)
- 가디언·옵서버(2016.2, 사명) · City AM(2014.1.27)·Mail & Guardian(2014.1.28, 인수와 투자자·윤리위원회) · Backchannel(2015, 구글 인프라 발언) · 구글 리서치 블로그(2015.2.25, DQN) · 딥마인드(알파고 소개, 37수·시청자) · Nature(2016.1 알파고 · 2017.10.19 알파고 제로) · Science(2018.12.6, 알파제로) · Nature(2019, 알파스타)
- phys.org(2020.11.30, CASP14) · Nature(2021.7.15) · EMBL(2022.7.28, 2억 개 구조) · 딥마인드(2024.5.8, 알파폴드 3) · 딥마인드 알파폴드 활용 사례(말라리아 백신·플라스틱 분해 효소) · VentureBeat(2024.10.9, 수상 성명 원문) · 구글 블로그(2024.10.9) · 왕립학회(2024.10) · 테크크런치(2024.3.29, 기사 작위) · 노벨상(1972, 크리스천 안핀슨)
성장기와 게임
뇌과학
딥마인드와 게임 AI
알파폴드와 노벨상
하편 「코드냐 세상이냐, 하사비스와 구글의 AGI 승부수」 이어 읽기 →
이 칼럼은 운영자가 주제와 분석 방향을 정하고 최종 검토·수정한 뒤 게시합니다. 자료 조사, 초안 작성, 인포그래픽 제작에는 AI 도구를 활용했으며, 모든 숫자는 출처와 대조해 확인했습니다.